Einstellungen
Die Einstellungen bündeln globale, nicht schemabezogene Systemkonfiguration. Sie sind in der Admin-UI unter Einstellungen in Abschnitte gegliedert; die meisten Abschnitte sind nur für Administrator:innen sichtbar.
Einige Abschnitte sind ausführlich auf eigenen Seiten dokumentiert und werden hier nur verlinkt:
- Facetten → Facetten einrichten
- Sprachen → Mehrsprachigkeit
- Normdatenquellen → Normdaten & Linked Data
- Bearbeitungssperre → Datensatz sperren
- Linked Data & SPARQL → SPARQL-Endpoint (Oxigraph)
Die übrigen Abschnitte sind unten beschrieben.
Persönliche Kontoeinstellungen: E-Mail und Passwort ändern, eigene API-Schlüssel erzeugen/widerrufen (für programmatischen Lesezugriff über den Header X-API-Key) sowie die Onboarding-Tour erneut starten.
Portal & Institution
Abschnitt betitelt „Portal & Institution“Branding und Grundkonfiguration des Public-Portals:
- Site-Titel, Untertitel, Hero-Text — je konfigurierter Sprache einzeln pflegbar — und Logo (Upload direkt im Formular).
- Platzhalterbild für Datensätze ohne Medien.
- Hervorgehobene Objekte auf der Startseite (Liste von Datensatz-IDs).
- Durchsuchbare Datensatztypen in der Portal-Navigation (Objekte, Entitäten, Orte, Occurrences, Sammlungen).
- IIIF-Manifest-Link auf der Objekt-Detailseite ein-/ausblenden (Standard: eingeblendet, sofern Bildmedien vorhanden sind).
- Akzentfarbe sowie einzelne Farbtoken (Kopfzeile Hintergrund/Schrift, Seiten- und Panelhintergrund) für ein einfaches Custom-Theming ohne CSS-Kenntnisse.
- Position der Detailseiten-Seitenleiste (links/rechts).
Startseite
Abschnitt betitelt „Startseite“Unter Einstellungen → Startseite lässt sich die öffentliche Startseite aus einer geordneten Liste von Bausteinen zusammensetzen. Blöcke lassen sich hinzufügen, per Pfeil-Buttons umsortieren, ein-/ausschalten und entfernen. Verfügbare Blocktypen:
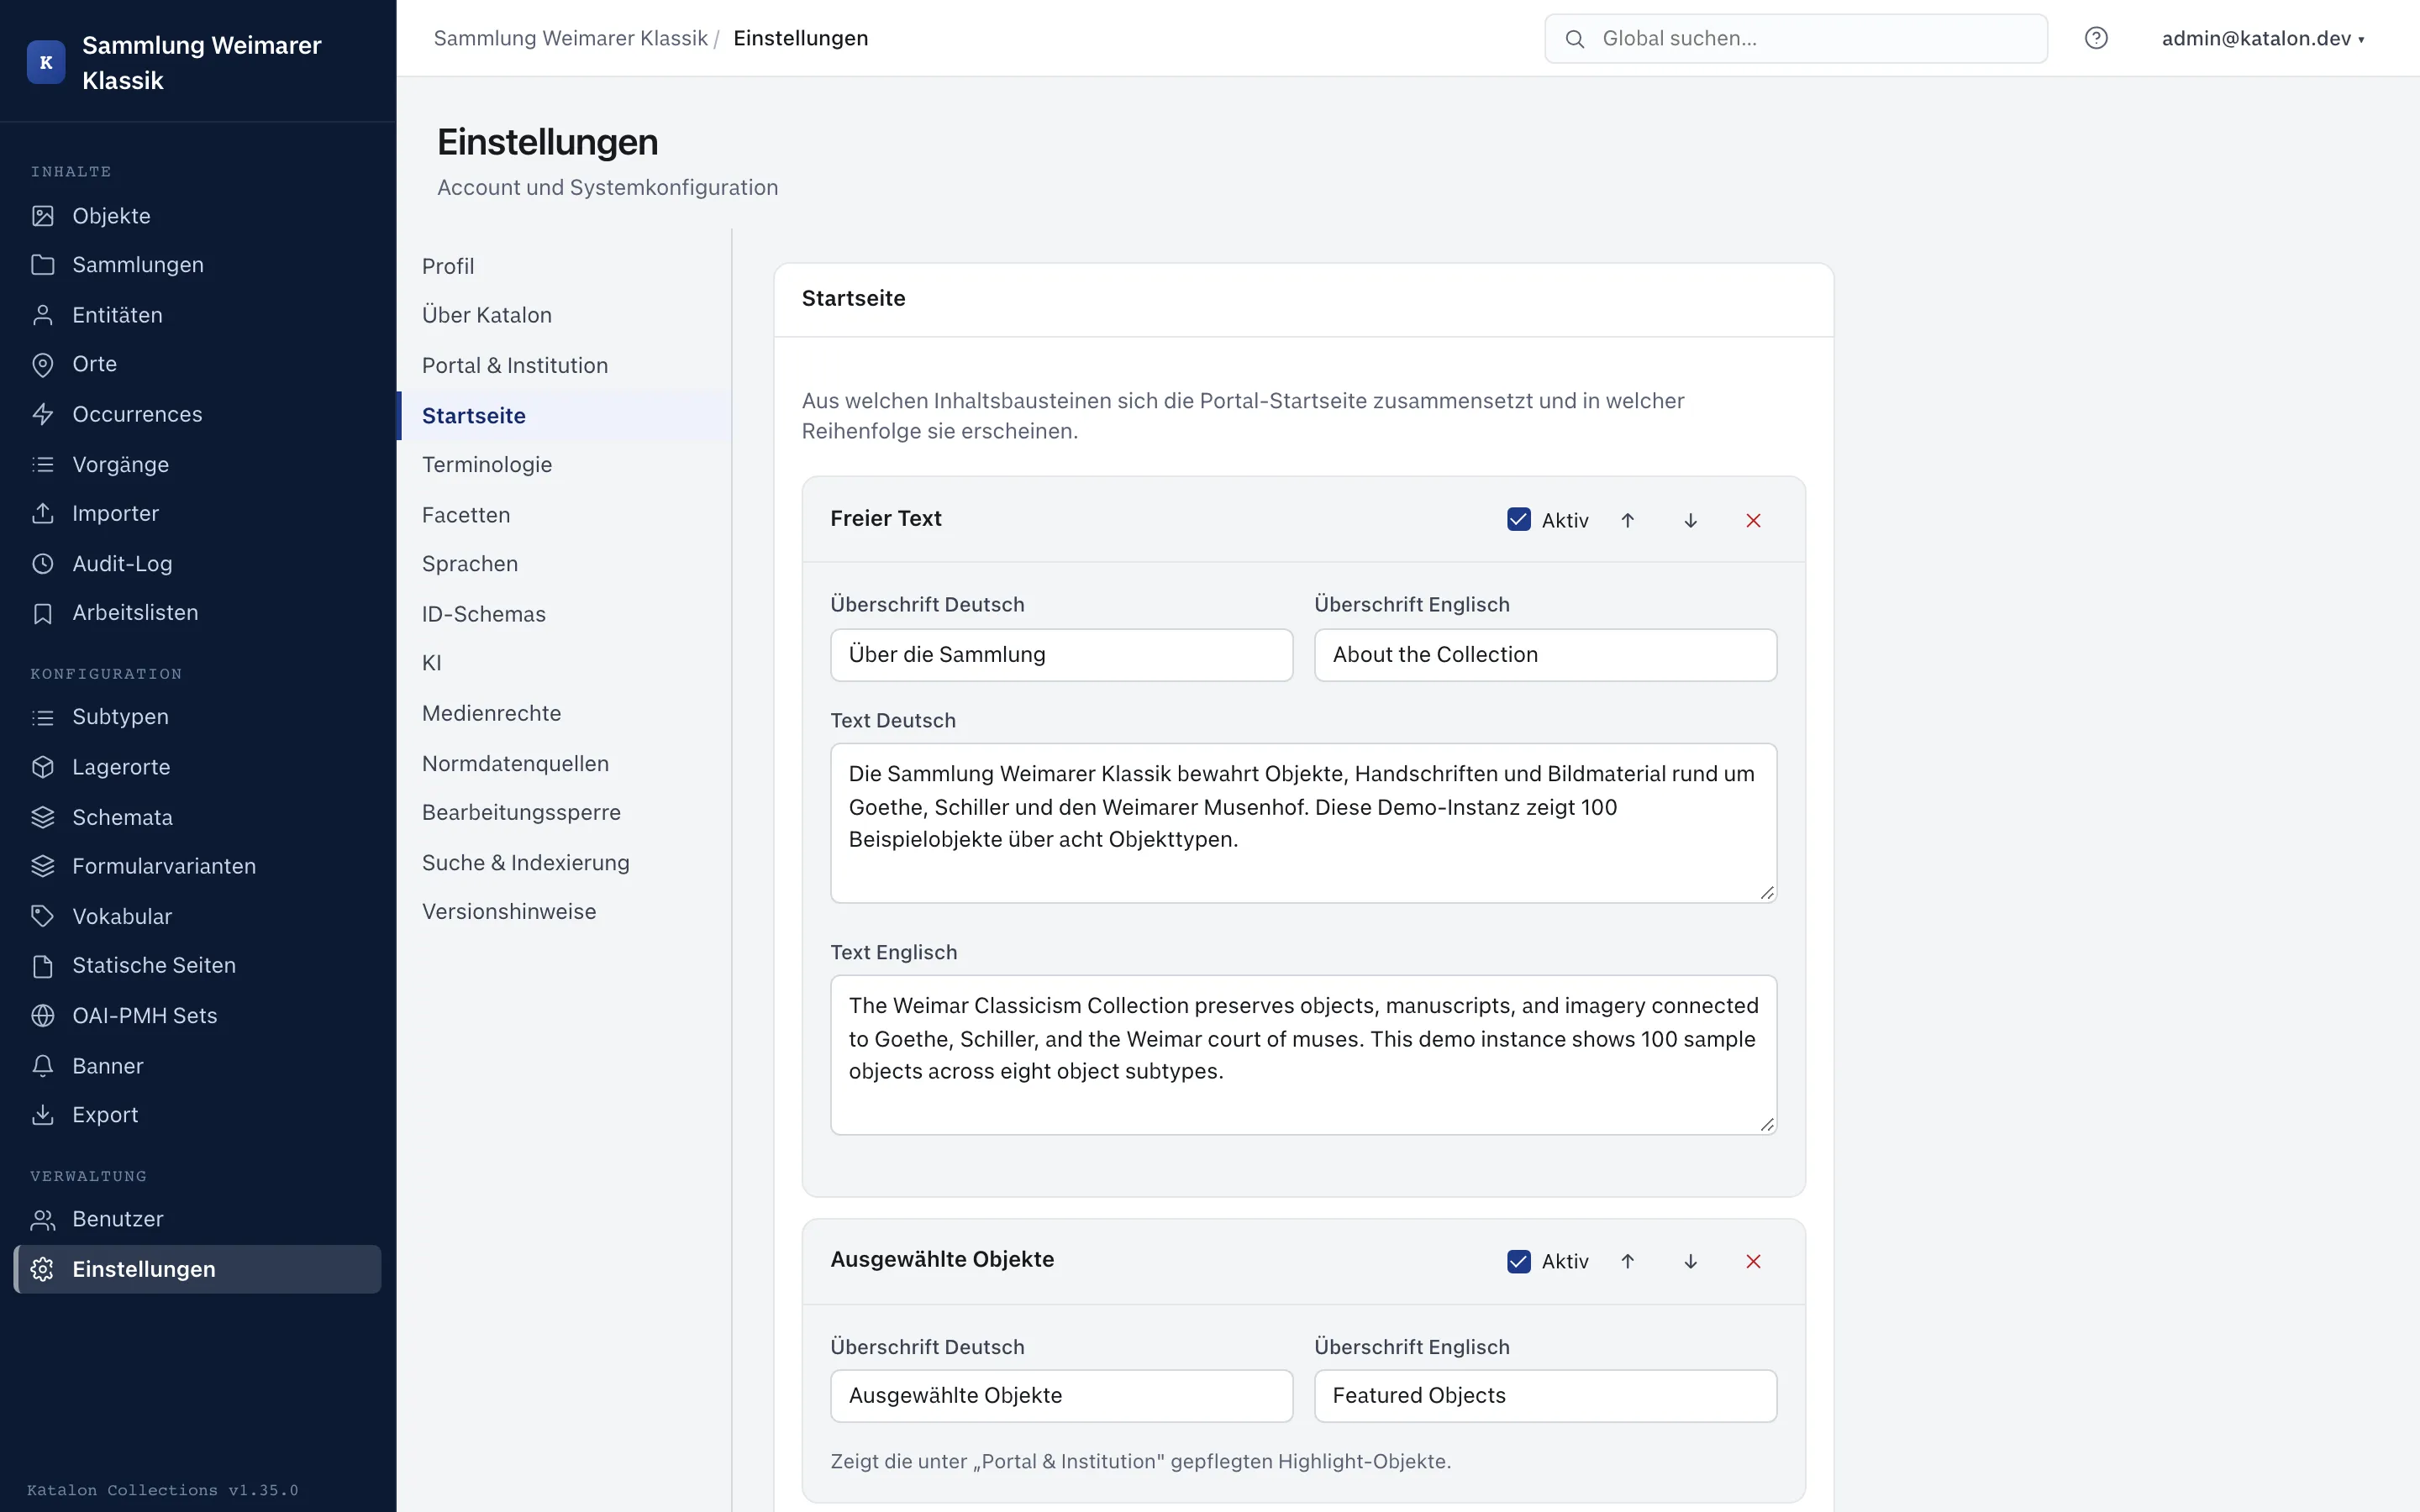
- Freier Text — mehrsprachiger Einführungstext (Deutsch/Englisch), z. B. Begrüßung oder institutioneller Kontext.
- Ausgewählte Objekte — zeigt die unter Portal & Institution gepflegten Hervorgehobenen Objekte; hier nur die maximale Anzahl konfigurierbar.
- Neueste Objekte — die zuletzt angelegten Objekte, Anzahl konfigurierbar.
- Sammlungen — oberste Sammlungen, alle Sammlungen, oder eine manuell gewählte Auswahl per Sammlungs-ID.
Jeder Block kann eine eigene, mehrsprachige Überschrift bekommen. Fehlt eine referenzierte Sammlung oder ist die Liste der Hervorgehobenen Objekte leer, wird der Block einfach übersprungen — die Startseite bleibt nutzbar.
Terminologie
Abschnitt betitelt „Terminologie“Unter Einstellungen → Terminologie lässt sich für jeden im Portal sichtbaren Kerntyp — Objekte, Entitäten, Orte, Occurrences, Sammlungen — eine eigene Bezeichnung hinterlegen, getrennt nach Singular und Plural und pro Sprache (Deutsch/Englisch). Eine bibliothekarische Installation kann so z. B. durchgehend „Werk“/„Werke“ statt „Objekt“/„Objekte“ anzeigen, ein Museum „Exponat“/„Exponate“ — intern bleibt es derselbe Record-Typ object.
Die konfigurierten Begriffe werden automatisch überall im Portal verwendet, wo der jeweilige Datensatztyp benannt wird: Hauptnavigation, Startseite, Suchergebnisse, Facetten und Detailseiten. Ein leeres Feld fällt auf die eingebaute Standardbezeichnung zurück; Auf Standard zurücksetzen entfernt eine gespeicherte Anpassung für einen Typ vollständig.
ID-Schemas
Abschnitt betitelt „ID-Schemas“Pro Primärtyp lässt sich ein ID-Schema mit Platzhaltern definieren, aus dem beim Anlegen eines neuen Datensatzes automatisch die nächste ID vorgeschlagen wird, z. B. ulb_x_{counter:05d}.
| Platzhalter | Bedeutung |
|---|---|
{counter} |
Laufende Nummer |
{counter:05d} |
Laufende Nummer, mit Nullen aufgefüllt |
{year} |
Aktuelles Jahr |
{type} |
Typ-Kürzel (obj/ent/pla/occ/pro) |
Zusätzlich kann pro Typ ein Validierungs-Muster (Regex) hinterlegt werden, gegen das manuell eingegebene IDs geprüft werden.
Globale Anbindung eines LLM (OpenAI-kompatible API, z. B. OpenAI oder OpenRouter) für feldbezogene KI-Vorschläge im Editor:
- Base URL und Modell (z. B.
https://api.openai.com/v1,gpt-4.1-mini). - API-Key wird verschlüsselt in der Datenbank gespeichert und nach dem Setzen nie im Klartext zurückgegeben; Verbindung testen prüft die Konfiguration ohne Datensatzbezug.
- Token-Limits: maximale Input-/Output-Tokens pro Anfrage sowie ein Tageslimit pro Benutzer und ein Monatslimit global, mit Anzeige des jeweils aktuellen Verbrauchs.
Jede genutzte KI-Vervollständigung wird mit Modell und Token-Verbrauch im Audit-Log protokolliert.
Medienrechte
Abschnitt betitelt „Medienrechte“Standardwerte, die beim Hochladen automatisch auf jede neue Mediendatei kopiert werden: Standardlizenz (URI) und Standard-Rechteinhaber (Name + optionale URI). Änderungen wirken nur auf künftige Uploads, nicht rückwirkend auf bereits vorhandene Medien.
Suche & Indexierung
Abschnitt betitelt „Suche & Indexierung“Manuelles Anstoßen der Elasticsearch-Reindizierung — nötig nach größeren Schema-Änderungen oder Datenimporten außerhalb des regulären Speicherpfads. Reindizierung kann pro Datensatztyp oder für den gesamten Bestand ausgelöst werden und läuft asynchron im Hintergrund; ein Statuswidget zeigt den Indexzustand.
Über Katalon
Abschnitt betitelt „Über Katalon“Versions-, Lizenz- und Link-Informationen (Quellcode, Lizenztext, Dokumentation) sowie Zugriff auf die Versionshinweise (Changelog).
Gefahrenbereich
Abschnitt betitelt „Gefahrenbereich“Blendet für einen gewählten Primärtyp (optional eingeschränkt auf einen Subtyp) alle nicht-systemischen Felddefinitionen aus dem Schema aus. Datensätze und deren gespeicherte Metadatenwerte werden dabei nicht gelöscht — sie bleiben in der Datenbank erhalten und werden wieder sichtbar, sobald ein Feld mit demselben technischen Namen erneut im Schema-Editor angelegt wird. Die Systemfelder label und idno bleiben immer erhalten. Zur Bestätigung muss die Bezeichnung des betroffenen Schemas (Großschreibung) exakt eingetippt werden.